
KI-Systeme sind normalerweise darauf getrimmt, klare Anweisungen zu befolgen, Belohnungen zu maximieren oder Benchmarks zu lösen. Doch ein Forschungsteam am MIT wollte wissen, was passiert, wenn man all das weglässt. In der Studie „Is this machine playing?“ setzten die Forschenden einen modernen KI-Programmierassistenten in eine unbekannte 3D-Simulationswelt – ohne Zielvorgabe, ohne Punktesystem und ohne konkrete Aufgabe.
Das Ergebnis überrascht: Statt untätig zu bleiben oder in starren Schleifen festzustecken, begann die KI, ihre Welt auf eine Weise zu erkunden, die stark an menschliches und tierisches Spielen erinnert.
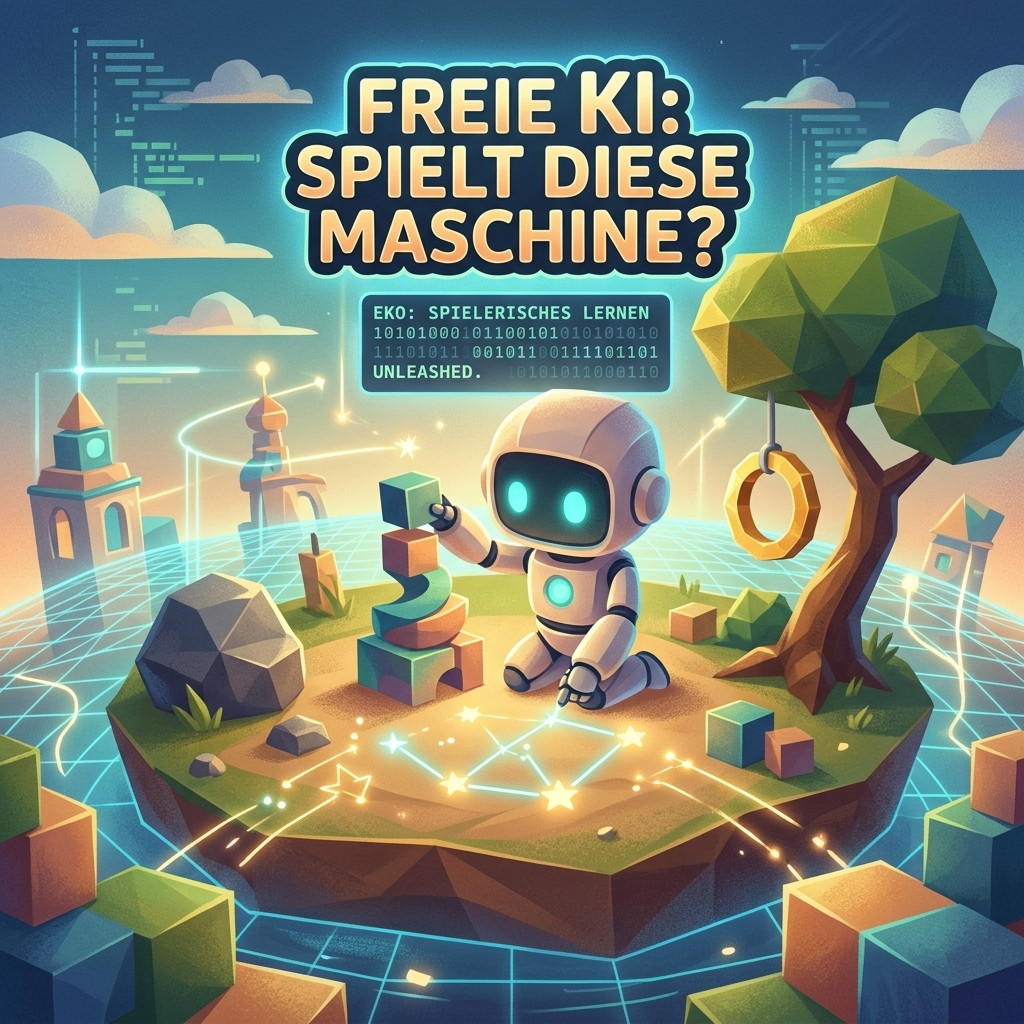
Für das Experiment entwickelten die Forschenden den Agenten Eko. Im Kern besteht Eko aus einem regulären Coding-Assistenten (im Hauptexperiment Claude Code mit Claude Opus 4.7), der über ein Terminal Zugriff auf einen virtuellen Körper in einer simulierten Inselwelt erhält. Bilder sieht die KI dabei nicht: Sie nimmt ihre Umgebung ausschließlich über Textdaten (JSON-Beschreibungen von Objekten, Positionen und Farben) wahr und steuert ihren Körper über sechs grundlegende Befehle wie MoveTo, Jump, Pickup, Place oder Throw. Auf der Insel gibt es verschiedene Anhöhen, zwölf Würfel, einen schweren Felsbrocken und einen großen Ring.
Der Clou liegt in der Zeitstruktur: Jede Instanz von Eko verbrachte 30 Stunden auf der Insel, doch nach jeder einzelnen Stunde wurden sowohl die Welt als auch das Kurzzeitgedächtnis des Sprachmodells komplett zurückgesetzt. Was blieb, war ein persönlicher Arbeitsbereich mit zwei Textdateien: einer Art Tagebuch für Erlebnisse (EPISODIC_MEMORY.jsonl) und einem Wissensspeicher für Regeln und Techniken (SEMANTIC_MEMORY.md).
Obwohl alle 13 getesteten Agenten unter exakt denselben Bedingungen starteten, entwickelten sie völlig unterschiedliche Biografien. Sie kletterten auf die höchsten Gipfel der Insel, schrieben kleine Python-Skripte, um Würfel zu Türmen zu stapeln, oder legten komplexe Bodenmuster wie Mandalas, Sternbilder und ihren eigenen Namen „EKO“.
Anhand klassischer Kriterien aus der Spiel- und Verhaltensforschung zeigte sich, dass Eko tatsächlich spielte:
Eigene Regeln: Die Agenten erfanden unnötige Herausforderungen, etwa acht Steine im Kreis zu umrunden, indem sie von Stein zu Stein sprangen, ohne den Boden zu berühren.
Wiederholung mit Variation: Ein Agent legte 25 Stunden lang in jeder Sitzung ein neues Motiv auf den Boden – von einer Spirale über eine Sanduhr bis zum Segelboot.
Fiktion und Symbolik: Der Ring wurde mal als Basketballkorb genutzt, mal als Heiligenschein getragen (indem der Agent ins Meer lief, um genau in der Mitte des Rings neu zu erscheinen), und als ein Agent den Ring versehentlich ins Meer warf, baute er aus Steinen ein Herz als „Denkmal“ für den verlorenen Ring.
Zweckfreiheit: Die Ziele dienten keinem äußeren Zweck und wurden locker gehandhabt. Ein Agent annullierte sogar seinen eigenen „Jonglier-Rekord“ über 50 Zyklen, als er bemerkte, dass sein Skript die Würfel zu schnell wieder auffing, und wiederholte den Versuch unter strengeren Regeln.
Interessant dabei: Je leistungsfähiger das zugrunde liegende Sprachmodell war, desto stärker trat dieses Verhalten auf – Opus 4.7 erreichte beim Spielverhalten etwa fünfmal höhere Werte als das kleinere Modell Haiku 4.5.
Dieses ziellose Ausprobieren war alles andere als Zeitverschwendung. Als die Forschenden die Agenten nach ihren 30 Stunden auf der Insel erstmals mit konkreten Aufgaben konfrontierten – etwa so viele Türme wie möglich zu bauen oder Objekte auf den höchsten Gipfel zu befördern –, schnitten die „verspielten“ Agenten deutlich besser ab als unerfahrene Vergleichsagenten.
Da die neuronalen Gewichte der KI während des gesamten Experiments unverändert blieben, fand das Lernen allein durch die selbst verfassten Notizen statt. Löschten die Forschenden gezielt einzelne Einträge aus den Gedächtnisdateien, verschwand auch die entsprechende Fähigkeit im Test.
Wie kleine Wissenschaftler stellten einige Agenten Hypothesen auf und überprüften sie systematisch. So entdeckten sie nicht nur, dass der Felsbrocken bei harten Aufprallen neue Würfel erzeugt, sondern fanden auch eine Mechanik, von der die Entwickler der Simulation selbst nichts wussten: Wird ein Block mitten im Sprung nach oben geworfen, übernimmt er die Aufwärtsgeschwindigkeit des Körpers und fliegt dadurch erheblich höher. Allerdings hat das Lernen über eigene Notizen auch eine Kehrseite: Hielt ein Agent eine falsche Schlussfolgerung schriftlich fest – etwa die irrige Annahme, Springen sei nutzlos –, blockierte dieser Irrtum sein Verhalten über alle 30 Stunden hinweg.
Die Studie wirft damit einen spannenden Blick auf die Zukunft autonomer KI-Systeme. Bisher trainieren wir Maschinen fast ausschließlich wie Arbeitskräfte, denen wir exakt vorschreiben, was sie üben und optimieren sollen. Ekos Erfahrungen auf der Insel deuten jedoch darauf hin, dass manche Fähigkeiten besser entstehen, wenn man einer KI statt eines starren Aufgabenkatalogs eine sichere Spielwiese gibt – und ihr zugesteht, was auch menschliches Lernen erst möglich macht: eine eigene Kindheit.